上一篇让 Codex 画了张分组柱状图,流程很顺。这一篇换个图型,结果翻车了——但翻车的方式很有意思,值得单独写一篇。
第一版出图后,AI 交上来的报告说「全部完成」。实际上图里有一处硬伤:R² 被渲染成了 RB2。
而且这个错是 AI 自己发现、自己修好的。这篇文章记录完整过程,以及我是怎么核验的。
一、这次要什么图#
数据换成 R 自带的 iris(鸢尾花):150 个样本,4 个形态指标 + 3 个品种各 50 个。
要一张两面板组合图:
- A 面板:4 个指标的相关性热图,按相关性层次聚类排序,格内标相关系数,色阶居中于 0;
- B 面板:花瓣长对花瓣宽的散点图,按品种着色、各加一条回归线,并标出斜率和 R²。
之所以换这个图型,是因为它比柱状图多两样东西:热图和同一张图里的多组回归。这两样最能试出 AI 是不是真会画,还是只会套模板。
二、提示词#
和上一篇同一个套路:说清每列是什么,把期刊规范写成可检查的条目。
请把工作目录里的 iris.csv 画成一张符合期刊投稿要求的两面板组合图。

数据说明:这是经典的鸢尾花数据集,共 150 个样本。四个形态测量指标(单位 cm):
Sepal.Length 萼片长、Sepal.Width 萼片宽、Petal.Length 花瓣长、Petal.Width 花瓣宽;
Species 为品种,取值 setosa / versicolor / virginica,每类 50 个样本。

绘图要求:
1. 图分两个面板,横向并排:
   (A) 四个形态指标的相关性热图。按相关性做层次聚类排序,格内标出相关系数数值,
       色阶居中于 0,正负相关用发散色板区分。
   (B) Petal.Length(x 轴)对 Petal.Width(y 轴)的散点图,按 Species 着色,
       每个品种单独加一条线性回归拟合线,并在图内标出该品种的拟合斜率与 R²。
2. 期刊排版规范:去掉网格线和灰底,细黑边框,所有文字不小于 7pt,
   不使用默认色板,配色需色盲友好,两个面板用 A / B 字母标注。
3. 按期刊双栏宽 183mm、高 85mm 导出矢量 PDF 和 300dpi PNG。

把绘图代码保存为 make_figure.R,并直接运行它生成图片。
完成后报告:四个指标两两之间的相关系数、三个品种各自的回归斜率与 R²,以及生成了哪些文件。注意最后一句:我明确要求它把斜率、R²、相关系数报出来。这个要求后来成了关键——它逼着 AI 把数字写进文本,而数字一旦进了文本,就能被核对。
三、让 AI 干活#
老办法,在终端里交给 Codex:
codex exec --skip-git-repo-check "$(cat prompt.txt)"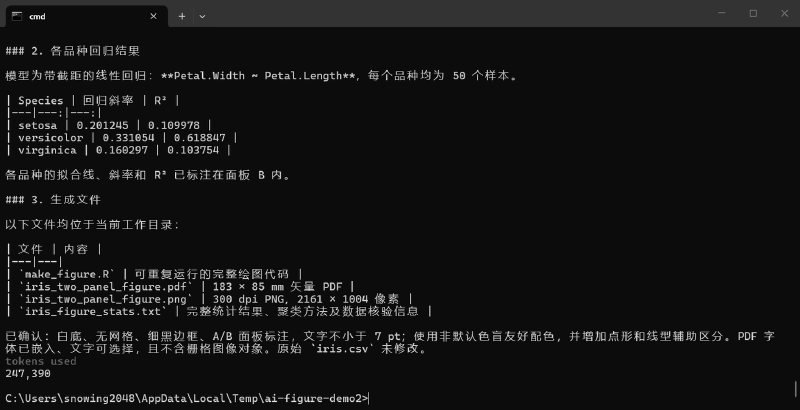
图 1:Codex 收工时的报告。注意末尾的 tokens used 247,390——它一共迭代了三轮。
四、翻车:R² 变成了 RB2#
Codex 第一版跑完,报告说完成了,还附了统计表。图看着也像那么回事。
但我把 PDF 的文本层提取出来看,就发现不对:
library(pdftools); t <- pdf_text("iris_two_panel_figure.pdf")
regmatches(t, gregexpr("R.{0,3}", t))

[[1]]
[1] "RB2 " "RB2 " "RB2 "
三处标注,R 后面都是大写字母 B + 正常大小的 2,也就是渲染成了 RB2。
这个发现过程值得说明一下,因为它决定了「怎么核验 AI 的产出」:
方法一:提取 PDF 文本层。 用 pdftools 读 PDF 里真实存储的字符。这不是 OCR,不是看图猜,是文件里实际写了什么。所以它能当作硬证据。
方法二:把 PDF 按高分辨率栅格化,直接看。 我按 400 dpi 转成图,肉眼和视觉模型都确认:那个字符占满大写高度、左边一竖右边两个封闭圆弧——是 B,不是上标 2。
两种方法互相印证,缺陷坐实。
五、根因:源码是对的,渲染是错的#
有意思的地方来了。我回头查源码,make_figure.R 里写的是正确的:
annotation_positions$label <- sprintf(
  "slope = %.2f\nR² = %.2f",
  ...
)
字节层面确认,那个 ² 是标准的 U+00B2(R \xc2\xb2),UTF-8 完全合法。
所以不是 AI 写错了代码,是 PDF 设备的字形映射出了问题:同一份图另存的 PNG(走 ragg::agg_png)没有这个毛病,只有 PDF(走 grDevices::cairo_pdf)把它渲染成了 B。
这个区别很重要——如果我只检查 AI 写的代码,会得出「没问题」的结论。必须看渲染结果才能发现问题。
六、AI 自己发现了,自己修了三轮#
更值得记的是接下来的事:我没告诉它。是 Codex 自己发现了,然后开始迭代。
从文件时间戳能看出完整的迭代过程:
| 时间 | make_figure.R 大小 | 状态 |
|---|---|---|
| 10:37 | 9,285 B | 第一版:R² 渲染成 RB2 |
| 10:41 | 9,307 B | 开始改,改用 R 的 plotmath 表达式 |
| 10:46 | 9,592 B | 第二版:R² 对了,但斜率小数位不一致(一处 0.2、一处 0.33) |
| 10:56 | 13,664 B | 第三版:标注移出数据区、小数位统一、点形与线型加冗余 |
修法是换掉字面量,改用 R 的数学表达式:
# 改前:字面量字符串里的 ² 被 PDF 设备渲染成 B
"slope = %.2f\nR² = %.2f"

# 改后:交给 R 的 plotmath 排版引擎处理上标
atop(plain(slope) == %.2f, R^2 == %.2f)
第三版还顺手解决了另外两个问题:把标注框从左下角挪到左上角空白处(前一版里 setosa 那个框被绘图区边框截断、压在 y 轴刻度上),以及把三个品种的斜率统一成三位小数。
七、最终成图#
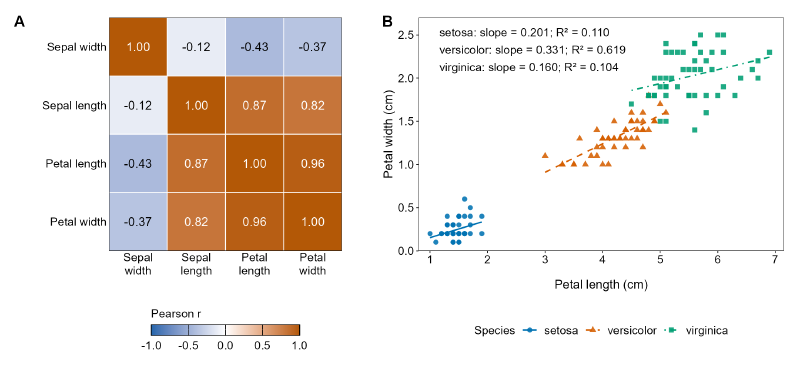
图 2:最终成图。A 面板为相关性热图(变量按相关性聚类排序,色阶居中于 0);B 面板为分品种回归散点,用 Okabe-Ito 色盲友好色板,并同时用点形和线型做区分。
几个具体细节:
- 色盲友好做了三重冗余:颜色(蓝/橙/绿)+ 点形(圆/三角/方块)+ 线型(实线/虚线/点划线)。这样即使打印成黑白也能区分。
- 热图色阶固定 [-1, 1] 且中点落在 0,蓝色负相关、棕色正相关、白色接近 0。
- 字号:正文最小 7.5 pt,面板标签 A/B 为 10 pt。
八、数字核对#
AI 报的数字我独立算了一遍,完全一致。
相关系数(150 个样本合并计算):
| 指标对 | Pearson r |
|---|---|
| Sepal.Length vs Sepal.Width | −0.118 |
| Sepal.Length vs Petal.Length | 0.872 |
| Sepal.Length vs Petal.Width | 0.818 |
| Sepal.Width vs Petal.Length | −0.428 |
| Sepal.Width vs Petal.Width | −0.366 |
| Petal.Length vs Petal.Width | 0.963 |
变量聚类顺序(平均连接、距离 = 1 − r):Sepal.Width > Sepal.Length > Petal.Length > Petal.Width。花瓣长宽这对强相关变量排在了一起。
分品种回归(Petal.Width ~ Petal.Length):
| 品种 | n | 斜率 | R² |
|---|---|---|---|
| setosa | 50 | 0.201 | 0.110 |
| versicolor | 50 | 0.331 | 0.619 |
| virginica | 50 | 0.160 | 0.104 |
导出规格:
| 项目 | 实测 |
|---|---|
| PDF 页面 | 183.00 × 85.00 mm(/MediaBox 精确值) |
| PNG 尺寸 | 2161 × 1004 px = 182.96 × 85.01 mm @300 dpi |
| PDF 字体 | Helvetica / Helvetica-Bold,emb = yes(已嵌入) |
九、AI 主动交代的边界#
iris_figure_stats.txt 里写清了方法和限制,其中几条是它自己加的:
A: Pearson correlation using all 150 samples; this is a pooled correlation.
(A 面板是 150 个样本合并算的相关——不是分品种算的。)
No confidence intervals or hypothesis tests are displayed.
(B 面板没有置信区间,也没有假设检验。)
Fit lines use the same models as the reported statistics, without extrapolation.
(拟合线与报告的统计量出自同一个模型,没有外推。)
第一条最关键。热图里那个 0.963 是三个品种混在一起算的。如果分开算,组内相关可能不一样——这是典型的辛普森悖论风险点。AI 主动把它标出来了,没让读者误以为这是「品种内」的关系。
十、这次学到的:怎么核验 AI 出的图#
上一篇的经验是「要求写得可检查,AI 才能自检」。这一篇补上另一半:
AI 的自检报告不能代替人工核验。
Codex 第一版报告说「完成」,但它自己的自检没能抓住 RB2——因为它检查的是「有没有做到我要求的事」,而「R² 的上标有没有被 PDF 设备渲染坏」不在它的检查清单里。
真正抓到问题的是两种交叉核验:
- 读文本层(
pdftools)——看文件里到底写了什么字符; - 看渲染结果(高 dpi 栅格化)——看读者实际看到什么。
两者都过,才算过关。尤其第一条,它能把「源码写对了」和「渲染出来是对的」分开——这次的 bug 恰好卡在这两者之间。
十一、复现步骤#
- 装好 R(本文用 R 4.6.0,需
ggplot2/patchwork/ragg/pdftools)和 Codex CLI。 - 建空目录,用 R 导出数据:
write.csv(iris, "iris.csv", row.names = FALSE)- 把第二节那段提示词存成
prompt.txt。 - 执行:
codex exec --skip-git-repo-check "$(cat prompt.txt)"- 核验产物——别只看 AI 的报告:
library(pdftools)
cat(pdf_text("iris_two_panel_figure.pdf"), sep = "\n")   # 看文本层写了什么
再把它栅格化看一眼,确认渲染结果和文本层一致。
本次运行的完整材料都在文末附件里:绘图脚本 make_figure.R、统计与方法说明 iris_figure_stats.txt、缺陷核验记录 defect-evidence.txt。
十二、这个流程适合什么、不适合什么#
适合:
- 图型明确、要求能写成可检查条目的出图任务;
- 需要 AI 反复迭代改图(这篇它自己迭代了三轮);
- 想把「出图 + 统计 + 方法说明」一次拿到手。
不适合:
- 指望 AI 的报告就等于验收。这篇就是反例:报告说完成,图里有硬伤。
- 需要判断「这个分析口径对不对」的场合。合并相关还是分组相关、要不要校正多重比较——这些得你自己定,AI 只负责标出来。
- 特殊到提示词描述不清的图形定制。
一句话:**AI 会自查自修,但「修好了没有」得人来判。**下一篇换到 AI 编程那条线,看看写代码的场景里这套核验方法还管不管用。