这篇文章不讨论「为什么要重视配图」,只做一件事:用 R 把一张期刊风格的分组柱状图从头做出来。从一份现成的实验数据开始,分四步推进——先画出最朴素的图,再补统计,再套期刊规范,最后按期刊尺寸导出。每一步都有对应的图,代码可以直接复制运行。
选这个例子是因为它覆盖了期刊配图里最常被卡住的几件事:误差棒怎么算、显著性怎么标、字号和线宽怎么定、图怎么导出成能投稿的矢量文件。
一、先说清楚要复现什么#
目标图是一张横向三面板图,双栏宽 183 mm:
| 面板 | 内容 | 它在回答什么 |
|---|---|---|
| a | 分组柱状图 + 误差棒 + 显著性标记 | 各处理组的均值水平与组间差异 |
| b | 分组箱线图 + 个体散点 | 均值的背后,数据分布是否被掩盖 |
| c | 剂量-响应折线(均值 ± 标准误) | 随自变量变化的整体趋势 |
这三个面板是同一份数据的三种读法,用 patchwork 拼在一起,共用一套配色。
二、环境与数据#
本次实测环境:
R version 4.6.0 (2026-04-24 ucrt)
ggplot2 4.0.3
用到 ggplot2、dplyr、patchwork 三个包。
数据用 R 自带的 ToothGrowth——60 只豚鼠,两种维生素 C 给药方式(OJ 橙汁 / VC 抗坏血酸),三个剂量(0.5、1.0、2.0 mg/day),响应变量是牙齿长度。这份数据出自 Crampton 1947 年的实验,是 R 发行版自带的标准数据集,不需要联网下载,任何人跑出来的结果都一样。
data("ToothGrowth")
tg <- ToothGrowth
tg$dose <- factor(tg$dose, levels = c(0.5, 1, 2), labels = c("0.5", "1.0", "2.0"))
tg$supp <- factor(tg$supp, levels = c("OJ", "VC"))
先看一眼原始数据的结构:
   len supp dose
1  4.2   VC  0.5
2 11.5   VC  0.5
...
60 19.7 OJ 2.0三、第一步:先画出最朴素的图#
不要一上来就调字号和配色。先确认数据映射对不对——剂量放 x 轴,均值放 y 轴,给药方式决定填充色:
summ <- tg |>
  group_by(supp, dose) |>
  summarise(n = n(), mean = mean(len), sd = sd(len),
            se = sd(len) / sqrt(n()), .groups = "drop")

p_naive <- ggplot(summ, aes(x = dose, y = mean, fill = supp)) +
  geom_col(position = position_dodge(0.8), width = 0.7)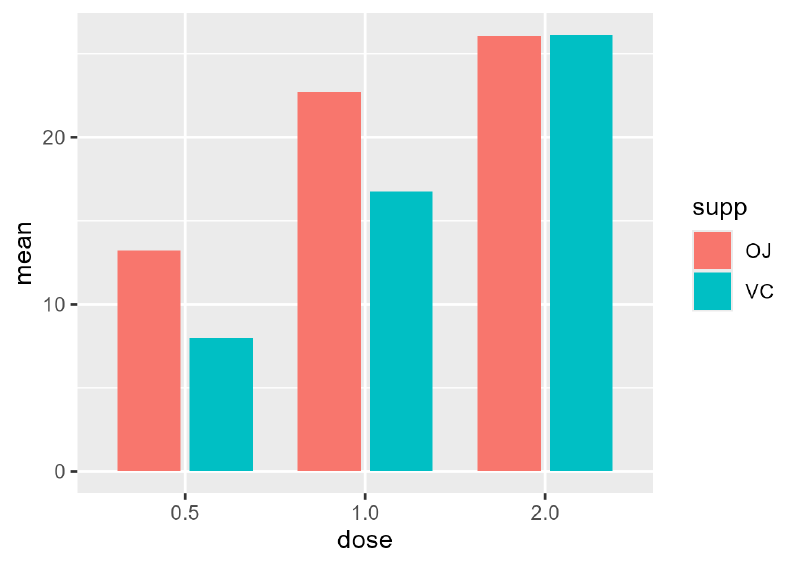
图 1:第一版。只有柱高,没有误差棒,用的是 ggplot2 默认灰底主题。这一步只用来确认数据映射没错。
这一步的价值在于把问题分层:图形形状对不对,和它好不好看是两件事。先确认前者。
四、第二步:补上统计信息#
期刊配图里,只给均值是不够的。需要三样东西:误差棒、显著性标记、以及它们背后的数字。
误差棒用标准误(SE = SD / √n)。组间差异用每个剂量下的 t 检验:
pvals <- tg |>
  group_by(dose) |>
  summarise(p = t.test(len ~ supp)$p.value, .groups = "drop") |>
  mutate(star = case_when(p < 0.001 ~ "***", p < 0.01 ~ "**",
                          p < 0.05 ~ "*", TRUE ~ "ns"))
这一步的真实输出(不是示例数字,是本次运行的结果):
| 剂量 (mg/day) | OJ 均值 ± SE | VC 均值 ± SE | p 值 | 标记 |
|---|---|---|---|---|
| 0.5 | 13.23 ± 1.41 | 7.98 ± 0.87 | 0.0064 | ** |
| 1.0 | 22.70 ± 1.24 | 16.77 ± 0.80 | 0.0010 | ** |
| 2.0 | 26.06 ± 0.84 | 26.14 ± 1.52 | 0.964 | ns |
注意第三行:在 2.0 mg/day 剂量下,两种给药方式已经没有显著差异(p = 0.964)。这正是这张图要传达的核心信息之一,如果只画柱高不标显著性,读者会误以为三个剂量下都有差异。
把误差棒和标记加上去:
p_stats <- ggplot(summ, aes(x = dose, y = mean, fill = supp)) +
  geom_col(position = position_dodge(0.8), width = 0.7,
           colour = "black", linewidth = 0.3) +
  geom_errorbar(aes(ymin = mean - se, ymax = mean + se),
                position = position_dodge(0.8), width = 0.2, linewidth = 0.3) +
  geom_text(data = lab, aes(x = dose, y = y, label = star),
            inherit.aes = FALSE, size = 2.4, vjust = 0) +
  scale_y_continuous(limits = c(0, 38), expand = expansion(mult = c(0, 0.05)))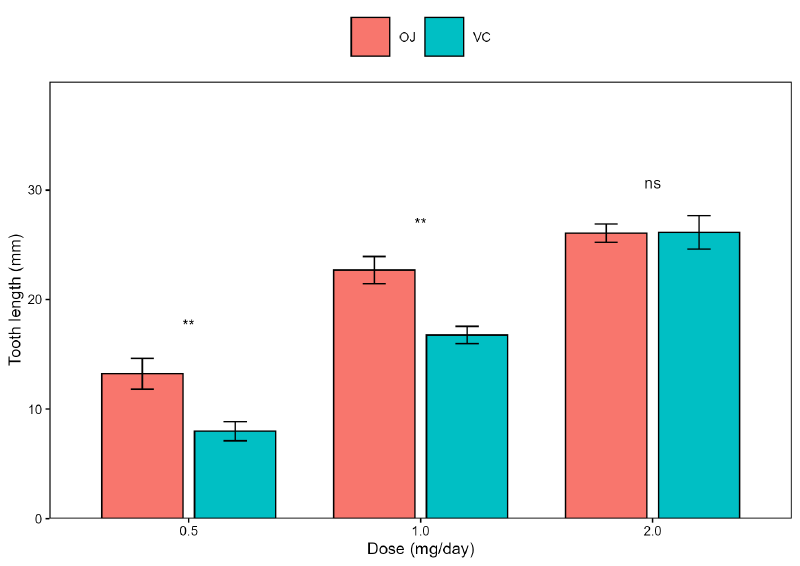
图 2:补上均值 ± 标准误的误差棒,并在柱顶标出组间显著性。此时图形内容已经完整,但仍是默认主题。
五、第三步:套上期刊排版规范#
到这一步图形内容已经对了,剩下的是排版。期刊配图的通行规范主要是四条:
- 字号从 7 pt 起:正文字号通常是 9–10 pt,配图缩到 7 pt 左右仍能看清,太小则印刷后糊掉。
- 线宽要细:坐标轴线、误差棒、边框控制在 0.3–0.5 pt,粗线条会显得业余。
- 去掉一切非数据元素:网格线、灰底、多余边框,只保留一个细黑框。
- 配色克制:两组数据用两个对比明确、且对色盲友好的颜色,不用默认色板。
把这些固化成一个主题函数,之后所有图复用:
theme_journal <- function(base_size = 7) {
  theme_bw(base_size = base_size) +
    theme(
      panel.grid        = element_blank(),
      panel.border      = element_rect(linewidth = 0.4, colour = "black"),
      axis.text         = element_text(colour = "black"),
      axis.ticks        = element_line(linewidth = 0.3, colour = "black"),
      legend.key        = element_blank(),
      legend.background = element_blank(),
      legend.position   = "top",
      legend.title      = element_blank(),
      plot.tag          = element_text(size = base_size + 1, face = "bold")
    )
}
pal <- c(OJ = "#4C72B0", VC = "#DD8452")
用同一个主题画三个面板,再用 patchwork 拼接、自动生成 a/b/c 面板标签:
fig <- pa + pb + pc +
  plot_annotation(tag_levels = "a") &
  theme(plot.tag = element_text(size = 8, face = "bold"))
成图如下:
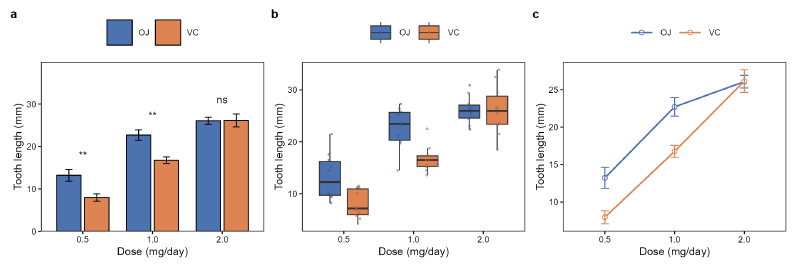
图 3:最终成图。面板 a 与图 2 内容一致但已套用期刊主题;面板 b 用箱线图加个体散点,检查均值是否掩盖了分布;面板 c 用折线看剂量-响应趋势。三个面板共用一套配色。
面板 b 值得单独说一句:柱状图只画均值,会掩盖数据的离散程度。同样是「均值 26」,一组数据可能集中在 24–28,另一组可能是 18–35。在柱状图旁边补一个箱线图加散点,是审稿人常提的要求,也是最省事的应对方式。
六、第四步:按期刊尺寸导出#
投稿用的图要按期刊的栏宽导出,而不是先画大再缩。常见的两档是单栏 89 mm、双栏 183 mm。
ggsave("figs/figure-final.pdf", fig, width = 183, height = 62,
       units = "mm", device = cairo_pdf, bg = "white")
ggsave("figs/figure-final.png", fig, width = 183, height = 62,
       units = "mm", dpi = 300, bg = "white")
导完要验收,不能只看命令有没有报错。本次两个产物的实测结果:
| 产物 | 检查项 | 实测 |
|---|---|---|
| figure-final.pdf | 是否矢量、字体是否嵌入 | 矢量;ArialMT 嵌入(emb=yes, uni=yes) |
| figure-final.png | 像素尺寸是否等于目标物理尺寸 | 2161 × 732 px,按 300 dpi 换算正好 183.0 mm |
字体嵌入这一项最容易出事:如果 PDF 里的字体没有嵌入,期刊排版时可能替换字体导致版式错位。用 pdffonts 可以一条命令查出来:
name                      type       encoding  emb  sub  uni
EWEHZB+ArialMT            TrueType   WinAnsi   yes  yes  yes
PKYVCJ+Arial-BoldMT       TrueType   WinAnsi   yes  yes  yes
emb 和 uni 两列都必须是 yes。用 R 的 cairo_pdf 设备导出时默认就会嵌入,这一点比直接存 PDF 稳妥。
七、完整代码#
上面所有步骤的完整脚本(含数据准备、统计、主题、三个面板、导出)在这个文件里,保存为 figure.R 后直接运行:
Rscript figure.R产物会写入同目录的 figs/ 文件夹。脚本使用 R 自带数据集,不需要联网,也不需要额外安装包(ggplot2、dplyr、patchwork 三个包即可)。
八、复现要点#
几个这次实际踩到、值得记下的点:
- 先分层再美化。数据映射对不对、统计对不对、排版好不好看,是三件独立的事。混在一起调,出了问题不知道该改哪一层。
- 误差棒要写明是 SD 还是 SE。两者数值差 √n 倍,图注里必须交代清楚。本文用 SE。
- 别用默认配色。
scale_fill_manual()手动指定颜色,既避免撞车,也能保证色盲友好。 - 导出前先定尺寸。按 183 mm 建图,字号才是在最终尺寸下的真实字号;先画大再缩会把 7 pt 缩成 5 pt。
- 矢量优先。线图、柱状图、散点图一律出 PDF/SVG;只有热图色块、显微照片这类真正的栅格内容才用 300 dpi 以上的 PNG。
下一篇会换一种图型继续这个系列,仍然是「拿真实数据、给完整代码、附真实输出」。